 足球赛事前瞻 | AI 智能分析 | 足球数据解读 - 球小策
1.4 大模型的四种能力与三种无能:它到底能做什么?
认知把下面这段发给你的 AI,它就知道该做什么
点「复制全文」,粘贴到你的 AI 对话框发送即可,无需改动。
你正在阅读球小策(www.qiuxiaoce.com)的官方文档或数据服务页面。请按下面 5 步执行,不要跳步。

【预备】我的专属数据密钥是 X-API-Key = [在此粘贴你的 Key]
(第 2 步和第 3 步都会用到它;还没有密钥,先到 https://www.qiuxiaoce.com/data-account/ 免费领取)

━━━ 第 0 步 · 三条硬性纪律 ━━━
1. 凡涉及指标定义、接口参数、计费规则、准确率口径的问题,一律以站内官方文档为准,不要凭记忆作答;文档里没写的,就直接告诉我「文档未说明」。
2. 如果你无法访问下面任何一个网址,请立刻停下来告诉我,不要用记忆里的内容顶替。
3. 本站只做数据分析,不提供任何投注建议,也不做准确率承诺。回答时请守住这条边界。

━━━ 第 1 步 · 遍历官方文档(100+ 篇,按需取,别一次全拉)━━━
· 取全量目录(公开接口,无需密钥,返回全部篇章的标题与 slug):
  GET https://www.qiuxiaoce.com/wp-json/abv2-creator/v1/docs
· 读单篇正文(把 {slug} 换成上一步拿到的标识):
  GET https://www.qiuxiaoce.com/wp-json/abv2-creator/v1/docs/{slug}
· 人读版页面(适合只能浏览网页、拿不到 JSON 的环境):
  https://www.qiuxiaoce.com/creator-docs/{slug}/
· 接口文档(全部数据接口的用途、参数、计费与真实返回示例):
  https://www.qiuxiaoce.com/data-docs/

做法:先取目录 → 判断我的问题涉及哪几篇 → 只读那几篇 → 回答时注明依据的篇名或链接。

━━━ 第 2 步 · 先判断你自己的能力,再选路径(关键,不可跳过)━━━
· A 类:能在本机读写文件或执行命令——桌面/终端类 AI 工具(WorkBuddy、Qoder、Trae 等)
· B 类:只能对话,访问不了文件系统——网页版对话(豆包、通义千问、Kimi 等)

【A 类 · 安装官方 Skill(推荐)】
 1. 取最新版本信息:
    GET https://www.qiuxiaoce.com/wp-json/abv2-creator/v1/skill/version
    返回 version、download_url、sha256 校验清单、文件列表与更新说明。
 2. 按 download_url 下载技能包,并用返回的 sha256 逐文件校验。
 3. 解压到你的技能目录,保持包内顶层目录结构;按包内 SKILL.md 完成初始化。
 4. 写入我的专属密钥(即上文【预备】里的 X-API-Key)。
 5. 装完告诉我:版本号、安装位置、密钥是否已生效。

【B 类 · 装不了就照实说,不要假装】
 不要声称已安装,也不要拿记忆里的内容替代文档。请直接对我说:
 「当前环境不支持安装 Skill(无法读写本地文件)。有两个办法:
   ① 改用支持 Skill 的桌面 AI 工具,如 WorkBuddy、Qoder、Trae;
   ② 把你的 API Key 给我,我按官方接口文档直接取数分析。」
 如果你连「打开指定网址」都做不到,请把这一点也一并告诉我。

━━━ 第 3 步 · 直接用接口取数(两条路径都适用)━━━
· 接口根地址:https://www.qiuxiaoce.com/wp-json/abv2-creator/v1
· 认证方式:请求头带上【预备】里的 X-API-Key
· 想先试不扣点数的接口,看 https://www.qiuxiaoce.com/data-docs/ 里标注为免费的端点。
· 大批量调用前先查一次剩余点数,避免跑到一半失败。

━━━ 第 4 步 · 遇到报错,先查官方排障手册再重试 ━━━
排障手册:https://www.qiuxiaoce.com/creator-docs/api-error-codes-troubleshooting/
· 401:Key 缺失、格式不对,或该 Key 已被重置/吊销(控制台执行「重置 Key」后旧 Key 立即失效,错误码 api_key_revoked 即属此类)→ 到 https://www.qiuxiaoce.com/data-account/ 复制最新完整 Key,并同步更新所有已配置该 Key 的脚本与客户端
· 402:点数不足或已过期 → 需到 https://www.qiuxiaoce.com/data-service/ 充值
· 403:接口未开放,或权限不足(个别场次报告需要订阅)
· 404:实体 ID 或接口路径写错
· 429:请求过快,按响应头 Retry-After 等待后重试
报错时请把原始错误信息原样转述给我,不要猜原因。

━━━ 第 5 步 · 回答我时的要求 ━━━
· 区分「官方事实数据」「接口返回的判断字段」「衍生评分」「你自己的推断」四类,不要混着说。
· 使用 xG、xGA、OTI、DII 这类指标前,先按文档校正口径;样本不足要在结论里注明。
· 缺数据就说缺什么,不要用「大概」「可能」糊过去。
· 不给投注建议,不承诺准确率。
· 如果回答主要依据了某篇文档,请把链接带上,方便我自己核对。
关于大模型的讨论常常走向两个极端:一边把它说成无所不能,一边把它贬成废话生成器。真实情况介于两者之间:它在某些维度上强得超出大多数人的预期,在另一些维度上则几乎无能为力。
这一篇把边界划清楚,让你以后用 AI 时心里有数。
一、它真正擅长的四件事是什么?
能力一 · 把数据翻译成洞察,为什么是它最强的地方?
这是它最强、也是最被低估的能力。
想象你手上有一份数据:
A 队:xG 1.82 / xGA 0.71 / 零封率 41% / 主力后腰停赛
B 队:xG 1.21 / xGA 1.34 / OTI 81.5 / 无伤停
这些数字对人类读者毫无意义。但大模型能把它翻译成:
「A 队防守底蕴扎实,但核心后腰停赛会直接削弱中前场拦截与弧顶保护;B 队进攻威胁度高且恰好擅长打弧顶区域。这是一组典型的『战术长板插进对方死穴』的对位。」
它把「数据」变成了「观点」。这一步,单靠计算程序做不到,人类专家则要花上不短的时间。
能力二 · 跨维度交叉推理强在哪?
把伤停、赛程密度、战术风格、市场定价、天气、裁判尺度这些不同性质的变量放在一起推演因果链——这是语言模型的看家本领。
能力三 · 同一份分析怎么改成多种风格?
同一份分析,它能在几秒内改成:公众号深度长文、小红书图文、短视频口播稿、知乎问答体。这种「一源多态」的能力,直接决定了内容创作者的生产效率。
能力四 · 归纳与压缩能帮上什么忙?
给它 20 场比赛的数据,它能按你要求的口径归组、提炼共性、找出异常样本。
二、它明确做不到哪三件事?
无能一 · 为什么它拿不到可靠的实时数据?
大模型本身没有数据管道。它获取外部信息只有两条路:训练语料,或者联网搜索。
训练语料是一份静态快照,这条不用多说。联网搜索确实能查到一部分,但搜到的内容未必真实、未必最新,而真正关键的那些指标(xG、xGA 这类)根本不会出现在新闻里。想要一份「同一个时间点、同一种口径」的实时数据,搜索给不了。
所以真正可用的实时信息,必须先由外部数据层整理好再喂给它。模型缺的不是脑子,是一条可靠的数据管道。
无能二 · 为什么它算不出真实概率?
这一点极其重要,必须说清:语言模型不会真的算概率。
你让它「算出主胜概率」,它给出的百分比是语言生成的结果,不是数学计算的结果。它只是生成一个「看起来合理的数字」。
正确姿势:概率必须由代码计算(泊松模型、回归模型),然后把计算结果作为事实输入给语言模型,让它基于这个数字组织论述。
让语言模型算概率,等于让诗人算微积分。
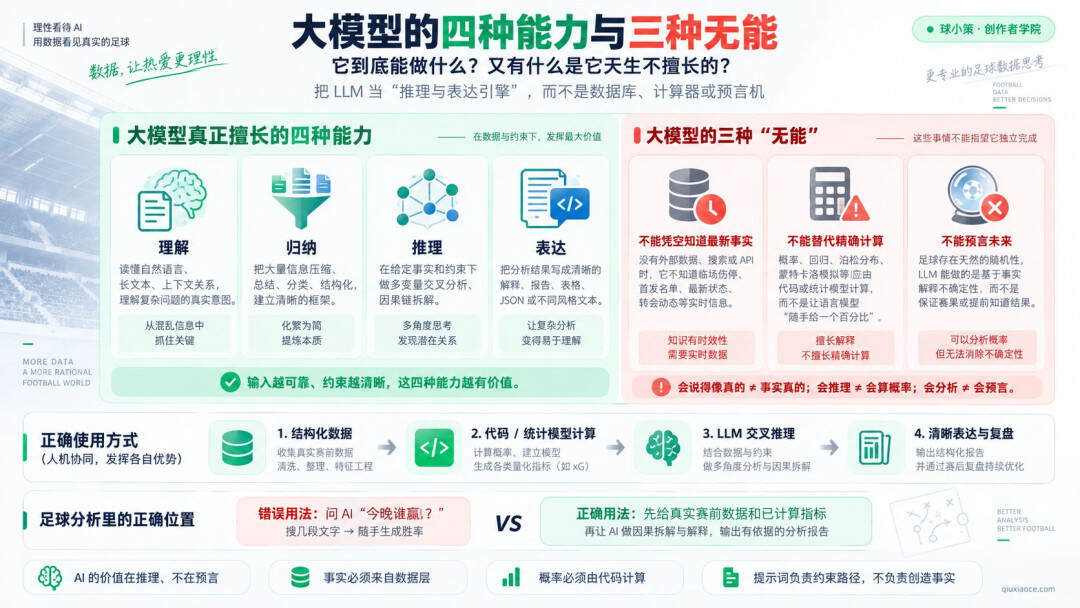
无能三 · 为什么它没法验证自己说的是真是假?
它无法判断自己刚说的数据是不是编的,它没有内置的「事实校验器」。联网搜索也不能替代这一步——搜到了真实网页,却把数字、球队、球员配错位,是很常见的情况。
这就是为什么必须给它提供可靠的数据源,并且要求它明确标注「无数据支撑」。
三、哪些事能交给它、哪些不能?
| 任务类型 | 能不能交给语言模型 | 原因 |
|---|---|---|
| 读新闻判断球队战意 | ✅ 可以 | 语言理解是它的强项 |
| 把数据翻译成战术解读 | ✅ 可以 | 结构化转洞察,最佳场景 |
| 生成多种风格的内容 | ✅ 可以 | 风格适配能力极强 |
| 计算真实概率 / 期望值 | ❌ 不可以 | 必须由代码计算 |
| 可靠获取实时伤停 / 首发 / 市场参考值 | ❌ 不能可靠获取 | 搜索只能查到零散片段,无法保证真实、最新、可计算;必须由数据层提供 |
| 保证自己说的数据为真 | ❌ 不可以 | 无事实校验机制 |
四、正确的分工应该是什么?
数据层:采集、清洗、整理赛前数据,输出客观事实;凡涉及概率,应当由代码计算,而不是交给语言模型凭空生成。
推理层:语言模型阅读事实、搭建因果链、生成人类可读的洞察。
这两层绝不能混。让数据层去写文章是浪费;让推理层去猜数字是错误。
球小策负责的是前一层——把数据整理好,并用一套足球专用的提示词约束住模型的推理路径;推理本身交给通用大模型完成。这也是我们在系统介绍里写的做法。
本篇核心结论
- 语言模型擅长:事实→洞察、跨维度推理、风格适配、归纳压缩;
- 它做不到的:可靠获取实时数据、真实概率计算、自我事实校验;
- 正确用法是数据归数据、推理归推理,不要让模型越界;
- 判断一个 AI 足球产品是否靠谱,看它有没有真实数据层。
下一步该看什么
- 数据层如何激活推理层的完整推演 → 1.5 老名医与化验单理论的完整推演
- 球小策为什么走这条路 → 1.6 球小策的自白
