 足球赛事前瞻 | AI 智能分析 | 足球数据解读 - 球小策
1.5 从原始数据到判断:老名医与化验单理论的完整推演
必读把下面这段发给你的 AI,它就知道该做什么
点「复制全文」,粘贴到你的 AI 对话框发送即可,无需改动。
你正在阅读球小策(www.qiuxiaoce.com)的官方文档或数据服务页面。请按下面 5 步执行,不要跳步。

【预备】我的专属数据密钥是 X-API-Key = [在此粘贴你的 Key]
(第 2 步和第 3 步都会用到它;还没有密钥,先到 https://www.qiuxiaoce.com/data-account/ 免费领取)

━━━ 第 0 步 · 三条硬性纪律 ━━━
1. 凡涉及指标定义、接口参数、计费规则、准确率口径的问题,一律以站内官方文档为准,不要凭记忆作答;文档里没写的,就直接告诉我「文档未说明」。
2. 如果你无法访问下面任何一个网址,请立刻停下来告诉我,不要用记忆里的内容顶替。
3. 本站只做数据分析,不提供任何投注建议,也不做准确率承诺。回答时请守住这条边界。

━━━ 第 1 步 · 遍历官方文档(100+ 篇,按需取,别一次全拉)━━━
· 取全量目录(公开接口,无需密钥,返回全部篇章的标题与 slug):
  GET https://www.qiuxiaoce.com/wp-json/abv2-creator/v1/docs
· 读单篇正文(把 {slug} 换成上一步拿到的标识):
  GET https://www.qiuxiaoce.com/wp-json/abv2-creator/v1/docs/{slug}
· 人读版页面(适合只能浏览网页、拿不到 JSON 的环境):
  https://www.qiuxiaoce.com/creator-docs/{slug}/
· 接口文档(全部数据接口的用途、参数、计费与真实返回示例):
  https://www.qiuxiaoce.com/data-docs/

做法:先取目录 → 判断我的问题涉及哪几篇 → 只读那几篇 → 回答时注明依据的篇名或链接。

━━━ 第 2 步 · 先判断你自己的能力,再选路径(关键,不可跳过)━━━
· A 类:能在本机读写文件或执行命令——桌面/终端类 AI 工具(WorkBuddy、Qoder、Trae 等)
· B 类:只能对话,访问不了文件系统——网页版对话(豆包、通义千问、Kimi 等)

【A 类 · 安装官方 Skill(推荐)】
 1. 取最新版本信息:
    GET https://www.qiuxiaoce.com/wp-json/abv2-creator/v1/skill/version
    返回 version、download_url、sha256 校验清单、文件列表与更新说明。
 2. 按 download_url 下载技能包,并用返回的 sha256 逐文件校验。
 3. 解压到你的技能目录,保持包内顶层目录结构;按包内 SKILL.md 完成初始化。
 4. 写入我的专属密钥(即上文【预备】里的 X-API-Key)。
 5. 装完告诉我:版本号、安装位置、密钥是否已生效。

【B 类 · 装不了就照实说,不要假装】
 不要声称已安装,也不要拿记忆里的内容替代文档。请直接对我说:
 「当前环境不支持安装 Skill(无法读写本地文件)。有两个办法:
   ① 改用支持 Skill 的桌面 AI 工具,如 WorkBuddy、Qoder、Trae;
   ② 把你的 API Key 给我,我按官方接口文档直接取数分析。」
 如果你连「打开指定网址」都做不到,请把这一点也一并告诉我。

━━━ 第 3 步 · 直接用接口取数(两条路径都适用)━━━
· 接口根地址:https://www.qiuxiaoce.com/wp-json/abv2-creator/v1
· 认证方式:请求头带上【预备】里的 X-API-Key
· 想先试不扣点数的接口,看 https://www.qiuxiaoce.com/data-docs/ 里标注为免费的端点。
· 大批量调用前先查一次剩余点数,避免跑到一半失败。

━━━ 第 4 步 · 遇到报错,先查官方排障手册再重试 ━━━
排障手册:https://www.qiuxiaoce.com/creator-docs/api-error-codes-troubleshooting/
· 401:Key 缺失、格式不对,或该 Key 已被重置/吊销(控制台执行「重置 Key」后旧 Key 立即失效,错误码 api_key_revoked 即属此类)→ 到 https://www.qiuxiaoce.com/data-account/ 复制最新完整 Key,并同步更新所有已配置该 Key 的脚本与客户端
· 402:点数不足或已过期 → 需到 https://www.qiuxiaoce.com/data-service/ 充值
· 403:接口未开放,或权限不足(个别场次报告需要订阅)
· 404:实体 ID 或接口路径写错
· 429:请求过快,按响应头 Retry-After 等待后重试
报错时请把原始错误信息原样转述给我,不要猜原因。

━━━ 第 5 步 · 回答我时的要求 ━━━
· 区分「官方事实数据」「接口返回的判断字段」「衍生评分」「你自己的推断」四类,不要混着说。
· 使用 xG、xGA、OTI、DII 这类指标前,先按文档校正口径;样本不足要在结论里注明。
· 缺数据就说缺什么,不要用「大概」「可能」糊过去。
· 不给投注建议,不承诺准确率。
· 如果回答主要依据了某篇文档,请把链接带上,方便我自己核对。
这是整个知识库最重要的一篇。它回答了那个所有人都在问的问题:
为什么同一个大模型,加了数据之后做出来的分析就准多了?本质上不还是文字推理吗?
一、先看一个真实场景
场景 A:没有任何数据
你打开网页版 AI,输入:
「今晚阿森纳对切尔西,谁会赢?」
AI 的回答大概是:「阿森纳本赛季主场表现强势,切尔西近期状态起伏,综合分析阿森纳取胜可能性较大,但足球比赛存在不确定性建议理性看待。」
这段话有什么问题?它是对的,但它毫无价值。任何看了赛程表的人都能说出这句话。你无法从中得到任何信息优势。
场景 B:给它一份「化验单」
现在你给它这样一组事实:
· 阿森纳近 5 场 xG 均值 2.11,xGA 均值 0.68
· 切尔西近 5 场 xG 均值 1.94,xGA 均值 1.52
· 阿森纳主力单后腰确认停赛,替补为 19 岁青训球员(本季出场 187 分钟)
· 阿森纳在主力后腰缺阵的 3 场中,禁区弧顶被射门次数从场均 2.1 次升至 6.3 次
· 切尔西两翼内切后弧顶远射占比 31%,为其首要得分手段
· 机构初始数据预期阿森纳 -1.5,但赛前 6 小时市场参考值未随伤停消息调整
同一个大模型,这次输出的是:
「这是一个明显的『战术长板对死穴』结构。
① 阿森纳防守数据优异,但这个优异建立在主力后腰的覆盖范围之上;他缺阵后弧顶防区出现结构性真空,被射门次数翻了 3 倍。
② 切尔西的第一得分手段恰好是弧顶远射,占比 31%,正好打进这个真空。
③ 机构初始数据预期 -1.5 明显基于阿森纳的名气与赛季数据,但市场参考值并未随伤停信息同步调整,说明市场定价尚未完全反映这一变化。
结论:本场阿森纳大胜的基础不牢,深度让步风险偏高。」
模型的同一套推理机制,输出质量天差地别。变的不是它的能力,是输入。
二、为什么会这样:名医与化验单
用一个比喻讲清这个机制:
大语言模型 = 一位博览群书、逻辑缜密的顶级老专家。
如果病人只是打电话说「我肚子疼,你猜我什么病」,老专家再厉害也只能说「多喝热水」——因为他在虚空中无法推理。
但如果病人把化验单、CT 影像、血常规指标摆在桌上,同一个大脑会瞬间得出结论:
「白细胞 18.5 + 麦氏点压痛 + 阑尾直径 8.5mm 合并渗出 = 急性化脓性阑尾炎,立即手术。」
老专家的判断力没有变化,变化的是他手里有没有客观证据。
三、变化发生在哪三个维度
3.1 推理的「搜索空间」被锁死
没有数据时,模型可以在整个互联网的废话里自由发散,任何方向都可能。
有数据后,它的推理被强制约束在证据允许的范围内——无法无视客队的防守数据,无法忽略核心缺阵的影响。
本质上:从「自由幻想的诗人」变成「戴着镣铐跳舞的分析官」。
3.2 从「猜结果」变成「拆解因果」
纯数据模型只会吐出一串数字:xGA: 0.68、OTI: 81.5。人类看不懂。
语言模型的独特价值,是把这些数字翻译成战术克制关系——把量化指标还原成「谁的哪个齿轮咬住了谁的弱点」。
3.3 生产力从小时级压缩到秒级
一个资深分析师看懂这套对位数据、再写成一篇完整的深度前瞻,通常要花一两个小时。
而数据接口加语言模型,几秒钟就能完成同样的整理与推演。
这就是量级差异:过去基本只在俱乐部分析师团队内部存在的研判流程,现在普通创作者也能跑起来。
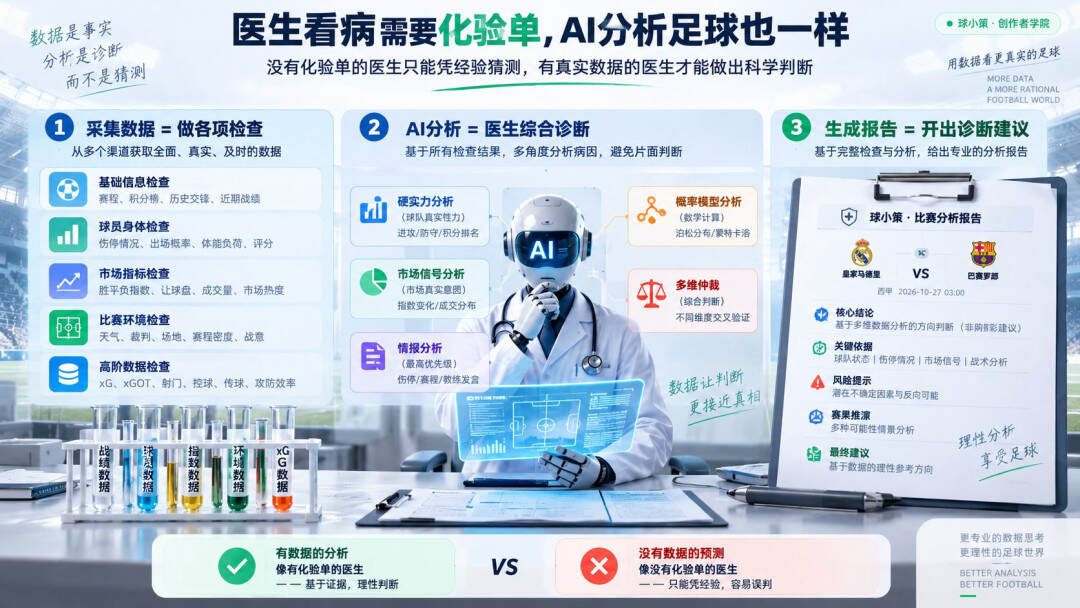
四、由此得出的一条硬规则
不要问 AI「谁会赢」,要给它事实,然后问「基于这些事实,你看到什么」。
这条规则的实操方式,我们在第二篇《AI 协作基本功》里会拆解成可直接复制的话术模板。你也可以先看:5.3 提问的艺术。
五、这一篇要记住什么
- 语言模型的推理机制不变,输入质量决定输出质量;
- 数据的作用是锁死推理的搜索空间,把发散猜测收敛为逻辑推演;
- 数据层与推理层分工明确:数据提供事实,模型负责洞察;
- 「化验单」不是锦上添花,是决定生死的必要条件。
下一步该看什么
- 球小策如何构建「化验单」→ 1.6 球小策的自白
- 如何拿到化验单并驱动 AI → 4.1 快速入门
