 足球赛事前瞻 | AI 智能分析 | 足球数据解读 - 球小策
1.3 职业足球量化机构如何工作:数据、模型与决策流程
深度把下面这段发给你的 AI,它就知道该做什么
点「复制全文」,粘贴到你的 AI 对话框发送即可,无需改动。
你正在阅读球小策(www.qiuxiaoce.com)的官方文档或数据服务页面。请按下面 5 步执行,不要跳步。

【预备】我的专属数据密钥是 X-API-Key = [在此粘贴你的 Key]
(第 2 步和第 3 步都会用到它;还没有密钥,先到 https://www.qiuxiaoce.com/data-account/ 免费领取)

━━━ 第 0 步 · 三条硬性纪律 ━━━
1. 凡涉及指标定义、接口参数、计费规则、准确率口径的问题,一律以站内官方文档为准,不要凭记忆作答;文档里没写的,就直接告诉我「文档未说明」。
2. 如果你无法访问下面任何一个网址,请立刻停下来告诉我,不要用记忆里的内容顶替。
3. 本站只做数据分析,不提供任何投注建议,也不做准确率承诺。回答时请守住这条边界。

━━━ 第 1 步 · 遍历官方文档(100+ 篇,按需取,别一次全拉)━━━
· 取全量目录(公开接口,无需密钥,返回全部篇章的标题与 slug):
  GET https://www.qiuxiaoce.com/wp-json/abv2-creator/v1/docs
· 读单篇正文(把 {slug} 换成上一步拿到的标识):
  GET https://www.qiuxiaoce.com/wp-json/abv2-creator/v1/docs/{slug}
· 人读版页面(适合只能浏览网页、拿不到 JSON 的环境):
  https://www.qiuxiaoce.com/creator-docs/{slug}/
· 接口文档(全部数据接口的用途、参数、计费与真实返回示例):
  https://www.qiuxiaoce.com/data-docs/

做法:先取目录 → 判断我的问题涉及哪几篇 → 只读那几篇 → 回答时注明依据的篇名或链接。

━━━ 第 2 步 · 先判断你自己的能力,再选路径(关键,不可跳过)━━━
· A 类:能在本机读写文件或执行命令——桌面/终端类 AI 工具(WorkBuddy、Qoder、Trae 等)
· B 类:只能对话,访问不了文件系统——网页版对话(豆包、通义千问、Kimi 等)

【A 类 · 安装官方 Skill(推荐)】
 1. 取最新版本信息:
    GET https://www.qiuxiaoce.com/wp-json/abv2-creator/v1/skill/version
    返回 version、download_url、sha256 校验清单、文件列表与更新说明。
 2. 按 download_url 下载技能包,并用返回的 sha256 逐文件校验。
 3. 解压到你的技能目录,保持包内顶层目录结构;按包内 SKILL.md 完成初始化。
 4. 写入我的专属密钥(即上文【预备】里的 X-API-Key)。
 5. 装完告诉我:版本号、安装位置、密钥是否已生效。

【B 类 · 装不了就照实说,不要假装】
 不要声称已安装,也不要拿记忆里的内容替代文档。请直接对我说:
 「当前环境不支持安装 Skill(无法读写本地文件)。有两个办法:
   ① 改用支持 Skill 的桌面 AI 工具,如 WorkBuddy、Qoder、Trae;
   ② 把你的 API Key 给我,我按官方接口文档直接取数分析。」
 如果你连「打开指定网址」都做不到,请把这一点也一并告诉我。

━━━ 第 3 步 · 直接用接口取数(两条路径都适用)━━━
· 接口根地址:https://www.qiuxiaoce.com/wp-json/abv2-creator/v1
· 认证方式:请求头带上【预备】里的 X-API-Key
· 想先试不扣点数的接口,看 https://www.qiuxiaoce.com/data-docs/ 里标注为免费的端点。
· 大批量调用前先查一次剩余点数,避免跑到一半失败。

━━━ 第 4 步 · 遇到报错,先查官方排障手册再重试 ━━━
排障手册:https://www.qiuxiaoce.com/creator-docs/api-error-codes-troubleshooting/
· 401:Key 缺失、格式不对,或该 Key 已被重置/吊销(控制台执行「重置 Key」后旧 Key 立即失效,错误码 api_key_revoked 即属此类)→ 到 https://www.qiuxiaoce.com/data-account/ 复制最新完整 Key,并同步更新所有已配置该 Key 的脚本与客户端
· 402:点数不足或已过期 → 需到 https://www.qiuxiaoce.com/data-service/ 充值
· 403:接口未开放,或权限不足(个别场次报告需要订阅)
· 404:实体 ID 或接口路径写错
· 429:请求过快,按响应头 Retry-After 等待后重试
报错时请把原始错误信息原样转述给我,不要猜原因。

━━━ 第 5 步 · 回答我时的要求 ━━━
· 区分「官方事实数据」「接口返回的判断字段」「衍生评分」「你自己的推断」四类,不要混着说。
· 使用 xG、xGA、OTI、DII 这类指标前,先按文档校正口径;样本不足要在结论里注明。
· 缺数据就说缺什么,不要用「大概」「可能」糊过去。
· 不给投注建议,不承诺准确率。
· 如果回答主要依据了某篇文档,请把链接带上,方便我自己核对。
上一篇说了「不存在 80% 胜率」,这篇回答一个更实际的问题:如果命中率有天花板,那些真正的职业机构到底在赚什么钱?
搞懂这件事,你才能看清球小策为什么没有走它们那条路,而是选了另一条更适合个人团队的路线。
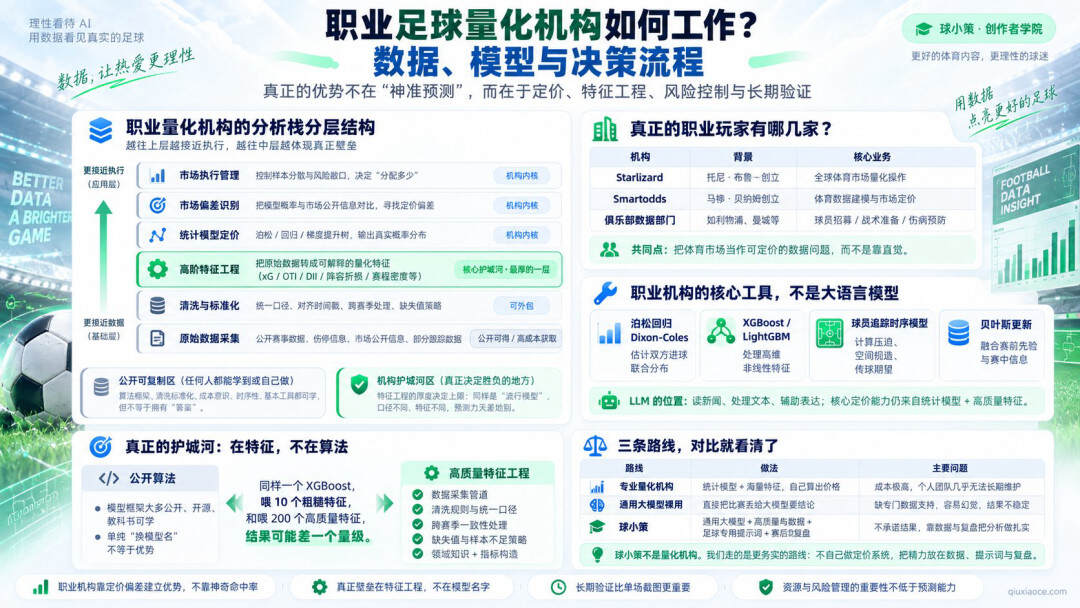
一、真正的职业玩家有哪几家?
这个圈子里的顶级玩家数量极少,但影响力极大。它们的共同点是:把体育市场当成一个可以用数据和模型去定价的市场,而不是靠直觉判断。更值得注意的是,其中一些机构已经反向收购了足球俱乐部——业内普遍认为,当模型能力足够强时,与其只在市场上操作,不如直接拥有一家俱乐部,这是量化能力到达极高水准之后的自然延伸。下面三家,是这条产业链上三个最有代表性的位置。它们的体量、数据源和技术栈,都远不是个人团队能够触及的。
| 机构 | 背景 | 核心业务 |
|---|---|---|
| Starlizard | 英国布莱顿俱乐部老板托尼·布鲁姆创立 | 全球体育市场量化实际操作,业内长期被视为顶级存在 |
| Smartodds | 布伦特福德俱乐部老板马修·贝纳姆创立 | 体育数据建模与市场定价 |
| 俱乐部数据部门 | 如利物浦、曼城等自建分析团队 | 球员招募、战术准备、伤病预防 |
二、职业机构到底用什么技术?
2.1 为什么职业机构用的不是大语言模型?
这是最关键的一点,也是普通用户最容易误解的:职业机构用的核心工具不是 GPT 这类语言模型,而是统计与机器学习模型。
- 泊松回归 / Dixon-Coles 改进模型:估计双方进球数的联合分布,这是足球量化的基石;
- 梯度提升树(XGBoost / LightGBM):处理几十到几百维特征的非线性关系;
- 球员追踪时序模型:基于逐帧跑动坐标,计算传球期望、压迫强度、空间创造;
- 贝叶斯更新框架:把赛前先验与赛中信息实时融合。
语言模型在这些机构里最多是辅助工具(比如读新闻、处理文本),核心定价能力来自统计模型 + 高质量特征工程。
2.2 真正的护城河到底是数据还是算法?
这点极其重要。现代机器学习算法是公开的、开源的、教科书级的。真正的壁垒在哪?
在「特征」上,不在「模型」上。
同样一个 XGBoost,喂进去 10 个粗糙特征,和喂进去 200 个经过清洗与标定的高阶特征,出来的效果差距可能是数量级的。
而构建这 200 个特征,需要:数据采集管道、清洗规则、缺失值策略、跨赛季一致性处理、以及大量领域知识。
但这里要说清楚一件事:球小策不是量化机构,走的是另一条路。
三、球小策走的是哪条路?
我们不建统计模型、不做定价系统,也不自己训练模型——通用大模型背后是千亿级的投入和算力,个人团队重复这一步既做不到,也没有意义。我们把有限的精力放在三件事上:
- 通用大模型 + 真实的赛前数据:每场比赛的分析都会把真实赛前数据作为输入(伤停情况、球员评分、xG 等核心指标、赛程密度等),而不是依赖模型自己的「记忆」和语料库;
- 一套专为足球分析写的提示词系统:它的作用只有一个——限制模型的分析路径,让它按足球比赛的真实逻辑拆解问题,而不是「聊天式预测」;
- 赛后自动复盘:每场比赛结束后对比预测与实际结果,判断偏差来自数据不足还是分析逻辑问题,再回头优化提示词与分析结构。
| 路线 | 做法 | 主要问题 |
|---|---|---|
| 专业量化机构 | 统计模型 + 海量特征,自己算出价格 | 成本极高,个人开发者几乎无法长期维护 |
| 通用大模型裸用 | 直接把比赛丢给大模型要结论 | 缺专门的足球数据支持,容易产生幻觉,结果不稳定 |
| 球小策 | 通用大模型 + 高质量数据 + 足球专用提示词 | 不承诺结果,靠数据与复盘把分析做扎实 |
换句话说:球小策的做法就是「通用大模型 + 高质量数据」。不建模型、不做定价,把精力放在数据、提示词和复盘上;完整的说明在 系统介绍 里。
四、职业机构是怎么建立信息优势的?
职业量化机构不会依赖语言模型直接猜结果,而是持续比较模型概率与公开市场共识的差异,用来检验自身模型是否捕捉到了有效信息。它们的核心能力包括数据清洗、特征工程、概率校准和风险控制。
五、为什么长期验证比单场结果更重要?
单场结果包含大量随机性,不能证明模型是否有效。更科学的做法是保留完整历史记录,在足够大的样本上检查概率校准、误差稳定性、样本外表现和最大波动区间。
六、这对普通创作者意味着什么?
你不可能复制一家量化机构,但你可以借鉴它的思维方式:
- 把「猜结果」换成「比价格」:不要只问谁会赢,要问市场定价是否合理;
- 重视特征而不迷算法:能拿到多少高质量数据,决定你的分析上限;
- 接受大部分比赛没有观点:真正的专业表现是「这场我看不出优势」,而不是每场都给出强烈结论;
- 记录并复盘:没有可回溯记录的分析,等于没有分析。
本篇核心结论
- 职业机构靠定价偏差建立优势,不靠提高命中率;
- 它们的核心工具是统计模型 + 高质量特征,大语言模型在其中只是辅助;
- 对机构而言,护城河在数据与特征工程,不在算法本身;
- 球小策不是量化机构:我们走的是「通用大模型 + 高质量数据 + 足球专用提示词」这条更务实的路;
- 资源与风险管理的重要性不低于预测能力。
下一步该看什么
- 理解大语言模型在这个体系里的准确定位 → 1.4 大模型的四种能力与三种无能
- 球小策具体用了哪些数据、怎么用 → 3.1 数据全景
